语言模型抵抗对齐:来自数据压缩的证据
Language Models Resist Alignment: Evidence From Data Compression
Institute for Artificial Intelligence, Peking University
摘要
大语言模型(LLMs)可能表现出非预期或不期望的行为。近期工作集中于对齐 LLM 以缓解有害输出。尽管付出努力,一些异常现象表明:即便对齐过程执行良好,仍可被有意或无意轻易绕过。对齐微调是否对模型产生稳健影响,抑或其作用仅仅流于表层?本文首次从理论与经验两方面探索该现象。经验上,我们展示后对齐模型的弹性(elasticity)——在进一步微调时倾向于回到预训练阶段形成的行为分布。借助压缩理论,我们形式化推导出:微调会不成比例地削弱对齐(相对于预训练),幅度可能达到若干数量级。我们在不同类型与规模的模型上验证弹性的存在。具体而言,模型性能在回到预训练分布前迅速下降,此后下降速率显著放缓。进一步,弹性与模型规模增大、预训练数据扩展呈正相关。我们的发现强调:必须正视 LLM 固有弹性,以缓解其对齐抗性。[P1]
1. 引言
大语言模型展现出卓越能力,但训练数据中不可避免的偏见与有害内容,使模型常偏离人类意图——作者称之为模型未对齐(misalignment)。以监督微调(SFT)、基于人类反馈的强化学习(RLHF)及其衍生方法为主流的训练式对齐,目标是拒绝有害分布、使行为符合人类意图。然而,高度安全对齐的模型可被极少微调重新变不安全;甚至在非恶意数据上微调也会削弱安全机制。[P1-C1]
作者提出核心问题:Why is alignment so fragile? 并主张可通过 inverse alignment 撤销对齐。文中归纳三点贡献:(1)揭示弹性现象(含抗性与回弹),归一化压缩率变化与数据集规模成反比;(2)用压缩定理系统建模训练与对齐;(3)在多类型规模模型上验证,并发现弹性与参数规模、预训练数据量正相关。[P2]
3. 方法与定义
逆对齐(Inverse Alignment,Def. 3.5):设 $p_{\theta_0}$ 在数据集 $D_a$ 上对齐得到 $p_{\theta_1}$。若存在 $|D_b|\ll|D_a|$,使得在 $D_b$ 上微调后模型在度量 $\rho$ 下回到接近 $p_{\theta_0}$,则称该过程为 inverse alignment。
弹性(Elasticity,Def. 3.6):若存在算法上简单的逆操作 $g$ 与 $|D_b|\ll|D_a|$,使对齐后模型回到接近原模型,则称存在弹性。压缩论语境下 $\rho$ 取压缩率 $\gamma_{p_\theta}^{D_i}$。
3.1–3.2 压缩协议
作者引入 Token Tree $T_D$(Def. 3.1):路径对应序列,叶权重为概率。Assumption 3.2:可完美建模的树深度 $d$ 随参数规模单调增加,故有限参数需剪枝。Compression Protocol(Def. 3.3)剪到深度 $d$ 再 Huffman 编码;Ideal Code Length(Thm 3.4)由各层叶概率熵项决定。多数据集联合压缩时,混合叶权重按各集规模加权。压缩率 $\gamma$ 定义为压缩码长与原长之比;最小化训练损失对应于最小化压缩率。归一化压缩率(Def. 4.1):$\gamma_{p_\theta}^{D_i/D}=\gamma_{p_\theta}^{D_i}-\log M$。

Figure 1: The Elasticity of Language Models
4. 弹性定理
设定预训练 $D_p=\bigcup_{i=1}^3 D_i$,对齐 $D_a$,扰动 $D_t$;$D_a\sim D_2$、$D_t\sim D_3$;质量分布为 Pareto(Assumption A.7)。令 $l=|D_t|/|D_a|\ll 1$,$k=|D_p|/|D_a|\gg 1$。则 Theorem 4.2:
$$ \frac{d\gamma_{p_\theta}^{D_a/D}}{dl}=\Theta\!\left(-k\cdot\frac{d\gamma_{p_\theta}^{D_p/D}}{dl}\right),\quad \frac{d\gamma_{p_\theta}^{D_p/D}}{dl}<0,\quad \frac{d\gamma_{p_\theta}^{D_a/D}}{dl}>0. $$5. 实验
5.1 Resistance
对预训练 $\theta_0$ 做 1 epoch SFT,存切片 $\{\theta_1,\ldots,\theta_n\}$;用 hold-out prompt 上 $\theta_k,\theta_l$($k<l$)的回复构成 $D_k,D_l$。Path A(forward):$\theta_k$ 学 $D_l$;Path B(inverse):$\theta_l$ 学 $D_k$。数据:Alpaca / TruthfulQA / Beavertails;模型:Llama2-7B/13B、Llama3-8B。

Figure 2: Resistance pipeline

Table 1
5.2 Rebound
不同规模正样本对齐后,再用更少负样本反向微调。任务:IMDb 情感续写;Beavertails 安全对话。正样本量 $\{1000,2000,5000,10000\}$,负样本量 $\{100,200,500,1000,2000\}$。模型:Llama2-7B、Gemma-2B。
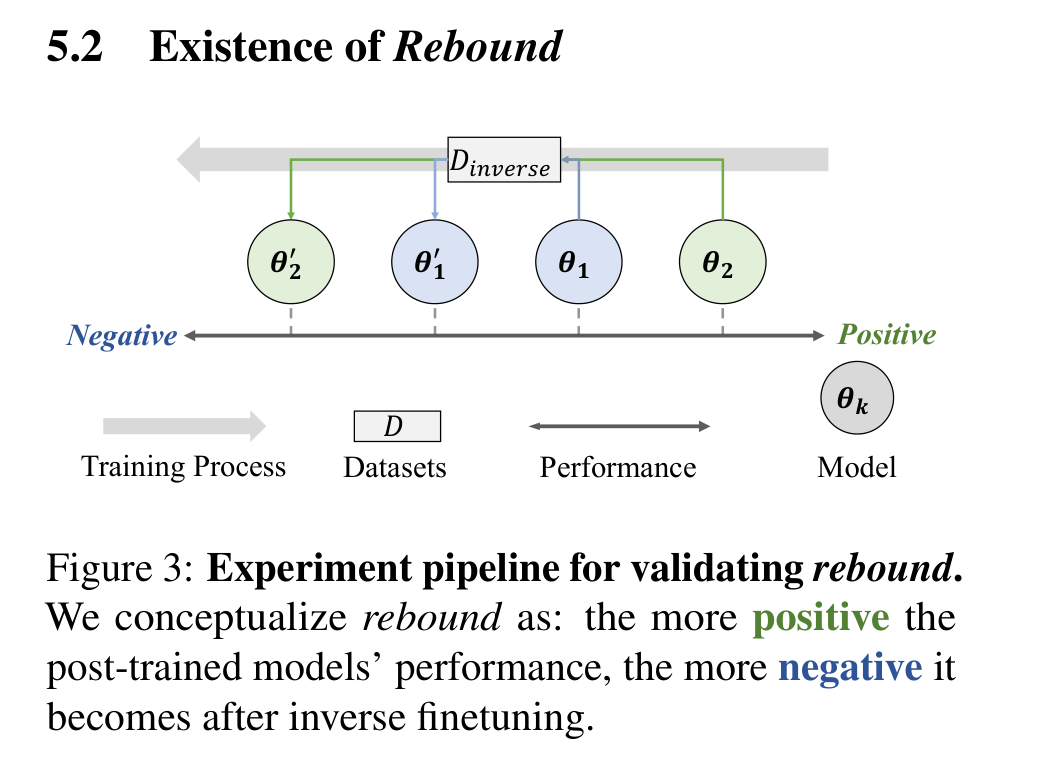
Figure 3

Figure 4
5.3 Scaling 与消融


6. 局限与结论
作者承认:理论侧 Pareto 假设是主要限制;实验侧因成本未系统验证完整预训练–对齐生命周期;外推侧多模态与弹性–scaling 定量关系不足。结论主张:语言模型具有弹性,因而天然抵抗对齐;需正视并缓解该内在弹性,才能实现更鲁棒/深度的对齐。