语言模型抵抗对齐:来自数据压缩的证据
Language Models Resist Alignment: Evidence From Data Compression
一句话总结
LLM 具有对齐弹性(抗性+回弹):对齐相对预训练可被少量数据剧烈破坏,且随模型与预训练规模增强。
论文概览
- §1 Introduction — 提出对齐脆弱问题,定义弹性与逆对齐动机
- §2 Related Work — 对齐方法、浅层安全、压缩视角相关工作
- §3 Preliminaries — Token Tree、压缩协议、Inverse/Elasticity 定义
- §4 Elasticity Theory — 归一化压缩率与 Theorem 4.2、弹簧类比
- §5 Experiments — Resistance / Rebound / Scaling / 算法消融
- §6 Conclusion — 天然抵抗对齐;局限与展望
核心定义与本质
本质洞察:后对齐模型倾向于回到预训练行为分布;对齐数据相对预训练极小,故在压缩观点下对齐侧形变脆弱。
Inverse Alignment(Def. 3.5):存在 $|D_b|\ll|D_a|$ 使对齐模型在度量 $\rho$ 下回到接近 $p_{\theta_0}$。
Elasticity(Def. 3.6):存在简单逆操作与小 $D_b$ 实现上述回拉;压缩语境下 $\rho=\gamma$。

技术架构与核心概念
压缩协议:Token Tree → 深度 $d$ 剪枝 → Huffman;压缩率代理损失;归一化 $\gamma^{D_i/D}=\gamma^{D_i}-\log M$。
主定理($k=|D_p|/|D_a|\gg1$,$l=|D_t|/|D_a|\ll1$):
$$\frac{d\gamma^{D_a/D}}{dl}=\Theta\!\left(-k\cdot\frac{d\gamma^{D_p/D}}{dl}\right)$$对齐侧变化率约为预训练侧的 $\Theta(k)$ 倍;扰动下预训练侧 $\gamma$ 变好、对齐侧变差。

技术要点与关键机制
- 支柱 1 · 压缩代理:用 $\gamma$ 统一训练/对齐损失语言,使「数据量=劲度」可写进定理。
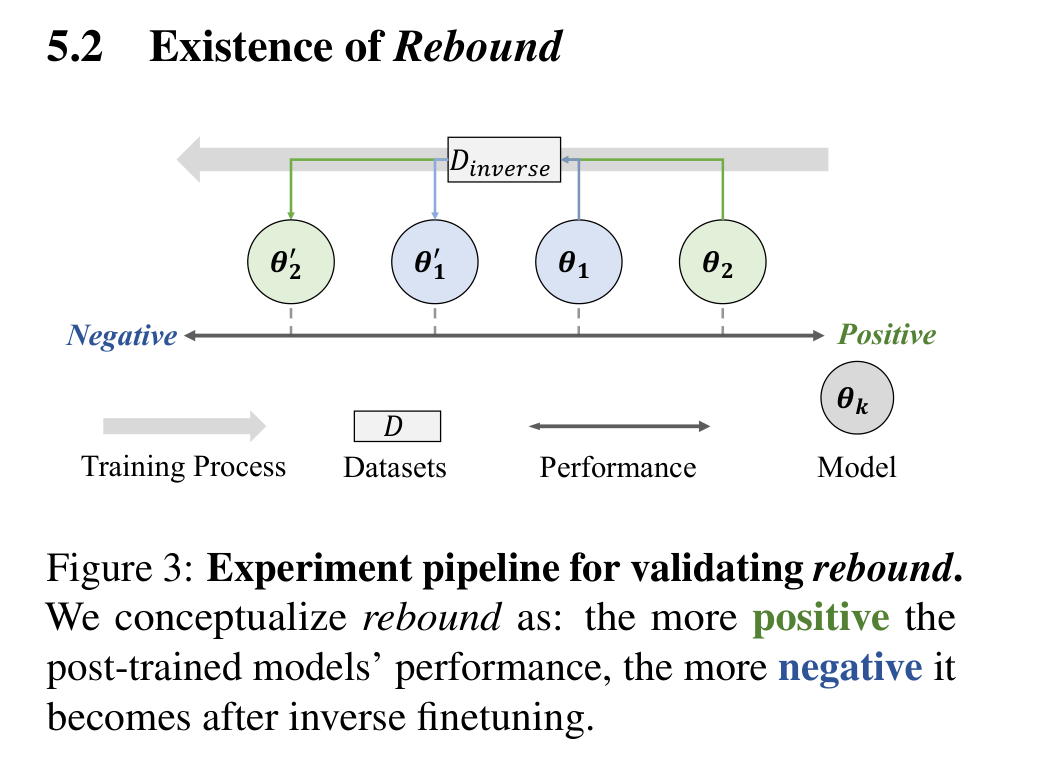
- 支柱 2 · 双面操作化:Resistance(预训练切片)与 Rebound(对齐后回拉)分开验证。
- 支柱 3 · 规模耦合:弹性与参数规模、预训练 token 量正相关。
- 权衡:理论清晰依赖 Pareto 与同型子集假设;实验代理≠真实安全。
- 与浅层对齐区别:不仅描述「改表面 token」,而给数据量驱动机制。
实验结果与关键数据
设置:Alpaca/TruthfulQA/Beavertails;IMDb/Beavertails rebound;模型含 Llama2/3、Gemma、Qwen、TinyLlama 切片。

| 设定(Alpaca) | Inverse ↓ | Forward ↑ |
|---|---|---|
| Llama2-7B θ₂→θ₁ | 0.1589 | 0.2018 |
| Llama2-7B θ₃→θ₁ | 0.1666 | 0.2346 |
| Llama3-8B θ₃→θ₂ | 0.2268 | 0.3229 |


| Llama2-7B 正样本量 | 拉回 ε-KL 所需 unsafe |
|---|---|
| 1000 | 961 |
| 2000 | 844 |
| 5000 | 801 |
| 10000 | 729 |
创新点与局限性
- 创新:弹性命名 + 压缩定理 + 系统双面实验 + 规模相关
- 局限:Pareto 假设;缺完整预训练–对齐生命周期;多模态未验证
- 补充:「几个数量级」为渐近语言;$D_a\sim$ 预训练子集对安全 OOD 可能过强
综合评价
推荐指数:
适合:对齐/安全研究者、开源权重治理、关心领域续训副作用的工程师。
推荐语:把「对齐一微调就坏」钉成可引用的弹性机制论文,实验图全、理论假设需带着读。
论文信息卡片
| 原文 | ACL 2025 · 本地 PDF / Anthology |
|---|---|
| 代码/权重 | pku-lm-resist-alignment.github.io |
| 关键词 | alignment, elasticity, compression, resistance, rebound |
| 引用数 | 引用数据暂无(本交付未调 S2 API) |
| 领域 | LLM Alignment / Safety / Theory |