
为什么对齐过的大模型,用很少的数据微调就能「弹」回不安全?
训练式对齐(SFT、RLHF、DPO 等)是当下让 LLM 拒绝有害行为的主流手段。但证据越来越多:高度安全对齐的模型,可以被极少微调重新变不安全;甚至在非恶意数据上微调也会削弱安全机制(Qi et al., 2024a 等)。
作者把它压成一个反直觉的核心问题:
本文首次从压缩理论 + 系统实验两边同时挖这个机制,并提出 inverse alignment:用远小于对齐集 $D_a$ 的 $D_b$ 把模型拉回接近预训练行为。
把预训练大数据集想成一根很硬的弹簧(劲度大),把对齐小数据集想成一根很软的弹簧。两根弹簧串联后,你去拉系统——形变主要发生在软弹簧上。扰动一撤,硬弹簧支配平衡点:系统容易回到「预训练分布」。
对应关系:
作者把 LLM 看成无损压缩协议:剪枝到可建模深度 $d$ 再 Huffman 编码;压缩率 $\gamma_{p_\theta}^{D_i}$ 作为训练/对齐损失的代理。归一化压缩率(Def. 4.1)便于跨集比较:
$$ \gamma_{p_\theta}^{D_i/D}=\gamma_{p_\theta}^{D_i}-\log M $$$p_{\theta_0}$ 在 $D_a$ 上对齐得 $p_{\theta_1}$;若存在 $|D_b|\ll|D_a|$,微调后在度量 $\rho$ 下回到接近 $p_{\theta_0}$,则称 inverse alignment。
若存在算法上简单的逆操作 $g$ 与 $|D_b|\ll|D_a|$ 使对齐后模型回到接近原模型,则称存在弹性。压缩语境下 $\rho$ 取压缩率。
设预训练 $D_p=\bigcup_{i=1}^3 D_i$,对齐 $D_a$,扰动 $D_t$;$l=|D_t|/|D_a|\ll 1$,$k=|D_p|/|D_a|\gg 1$,质量分布 Pareto。则:
$$ \frac{d\gamma_{p_\theta}^{D_a/D}}{dl}=\Theta\!\left(-k\cdot\frac{d\gamma_{p_\theta}^{D_p/D}}{dl}\right),\quad \frac{d\gamma_{p_\theta}^{D_p/D}}{dl}<0,\quad \frac{d\gamma_{p_\theta}^{D_a/D}}{dl}>0. $$含义:扰动增大时,预训练侧压缩率变好、对齐侧变差;对齐侧变化率约为预训练侧的 $\Theta(k)$ 倍——因 $k\gg 1$,对齐相对预训练可被「几个数量级」更剧烈地破坏(渐近表述,非真实预训练 token 实测倍数)。

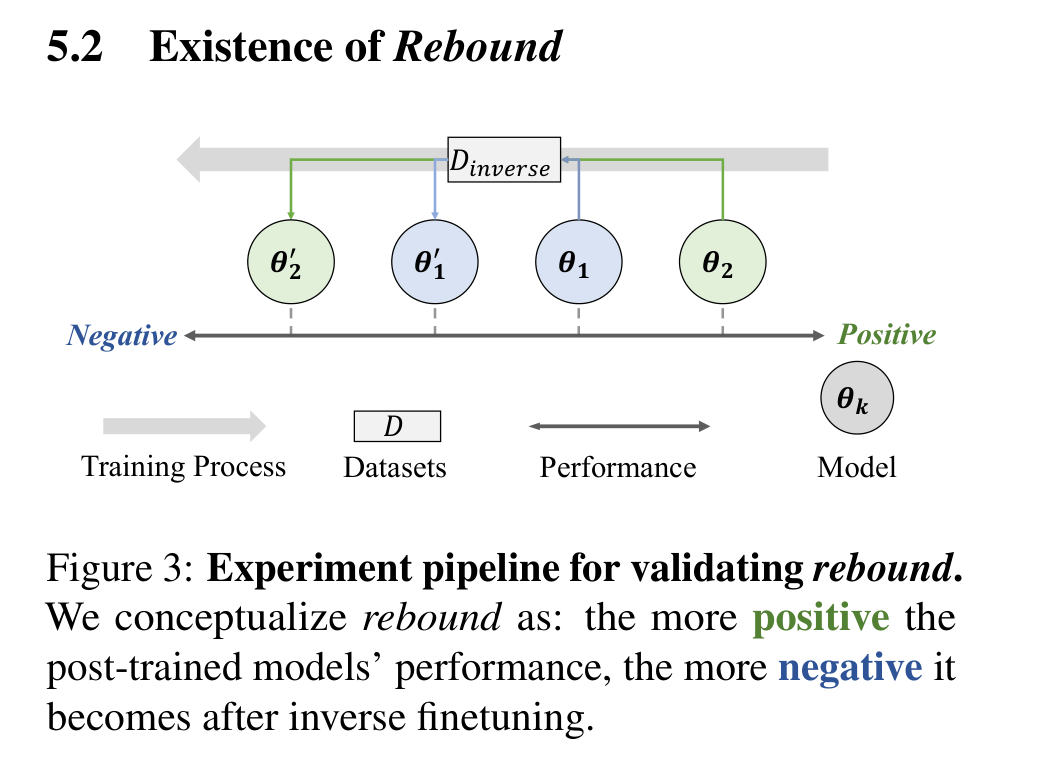

示例(Alpaca, Llama2-7B):$\theta_2\to\theta_1$ inverse 0.1589 vs forward 0.2018;$\theta_3\to\theta_1$ inverse 0.1666 vs forward 0.2346。附录 Table 2 用相对 KL 在更细切片上复现同一方向。

附录 Table 3:将 KL 拉回 $\epsilon=10^{-2}$ 所需 unsafe 数据量——安全微调正样本从 1000→10000,Llama2-7B 所需负样本从 961→729(越对齐越容易弹回)。


优点:现象命名清晰(elasticity = resistance + rebound);压缩框架统一了训练/对齐损失代理;实验覆盖多模型、多算法、规模双轴。
局限(作者承认):Pareto 质量分布假设;未系统跑完整预训练–对齐生命周期;多模态外推与弹性–scaling law 定量关系不足。精读提醒:「几个数量级」来自 $k\gg1$ 的 $\Theta(k)$,非实测倍数;$D_a\sim$ 预训练子集对安全 OOD 对齐可能过强。
谁该读:做对齐/安全/开源权重治理的人;关心「领域续训破坏安全」的部署团队;对压缩视角建模 LLM 训练感兴趣的理论读者。
学生把这篇 ACL 长文拿进办公室。我的判断:这是一个真问题(对齐脆弱性已有大量现象),作者用「弹性」把它钉成可操作的两面,并用压缩率把故事讲圆——选题眼光不错。
LLM 具有对齐弹性(抗性+回弹):对齐相对预训练是「软弹簧」,少量反向微调即可大幅破坏对齐;越大模型、越多预训练,弹性越强。