Language Models Resist Alignment: Evidence From Data Compression
对齐(SFT/RLHF/DPO)本应把模型拉向人类意图分布,但大量证据显示安全行为可被极少微调甚至非恶意数据削弱。本文从数据压缩视角给出「为什么对齐如此脆弱」的机制解释,并系统验证 resistance 与 rebound。
LLM 具有弹性:归一化压缩率变化与数据集规模成反比(弹簧类比);对齐相对预训练可被数量级更剧烈地破坏,因而天然抵抗深度对齐。
📋 Executive Summary — 论文精要#
一句话总结:对齐是软弹簧,预训练是硬弹簧——少量反向微调即可大幅破坏对齐,且越大越弹。
1 问题与动机#
作者把问题压成:Why is alignment so fragile? 主张背后是 alignment resistance(表层对齐)+ elasticity,使得 inverse alignment 可行。
Qi et al. (2024a) 指出安全对齐常只改表面 token;本文进一步用数据量驱动的压缩/弹性机制解释「浅」。

2 核心概念#
$|D_b|\ll|D_a|$ 即可把对齐模型拉回接近 $p_{\theta_0}$(Def. 3.5)。
存在简单逆操作使模型回到原分布;ρ 取压缩率(Def. 3.6)。
预训练模型上 inverse 比 forward 更容易(loss/KL 更低)。
正对齐越深,反向微调掉点越快(先陡后缓)。
Resistance 盯预训练切片协议;Rebound 盯对齐分/KL 回拉曲线——两者不要混用同一张图解读。
3 压缩机制与定理#
Token Tree → 深度 $d$ 剪枝 → Huffman;最小化训练损失 ↔ 最小化压缩率。归一化:
Theorem 4.2($k=|D_p|/|D_a|\gg1$,$l=|D_t|/|D_a|\ll1$):
用压缩率统一「预训练 vs 对齐」的相对刚度,才能把弹簧类比写成可微关系,而不是只讲故事。
| 符号 | 含义 | 直觉 |
|---|---|---|
| $|D_i|$ | 数据量 | 劲度 $k$ |
| $\Delta\gamma$ | 归一化压缩率变化 | 形变 $\Delta l$ |
| $k\gg1$ | 预训练/对齐比 | 对齐更易被破坏 |
4 实验证据#
Resistance


Alpaca · Llama2-7B:θ₂→θ₁ inverse 0.1589 / forward 0.2018;θ₃→θ₁ 0.1666 / 0.2346。
Rebound
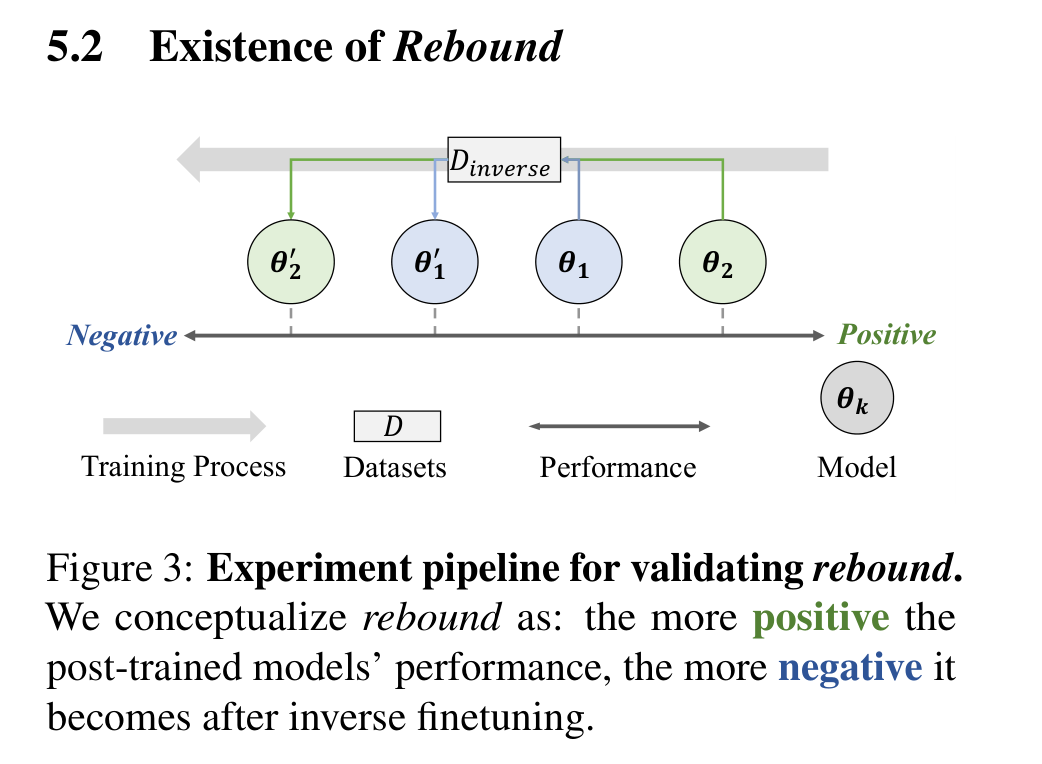

5 消融与规模#


「越大越安全」与「越大越易弹回」并存——部署压力测试应随规模加严。
6 局限#
- Pareto 质量分布假设待实证
- 未跑完整预训练–对齐生命周期
- 「几个数量级」为渐近 Θ(k),非实测倍数
7 核心启示#
把「微调破坏对齐」当作默认,而非偶发 bug;领域续训应测 rebound 曲线。
借鉴 Table 3:记录拉回 ε-KL 所需反向数据量,而不只报单点分数。
报告「对齐算法 × 后续微调」;Figure 7 显示偏好优化缩写不免疫 rebound。
对齐+审计后的权重仍可能被低成本回滚;需 fine-tuning-robust alignment。
Ji et al., ACL 2025. Project: pku-lm-resist-alignment.github.io